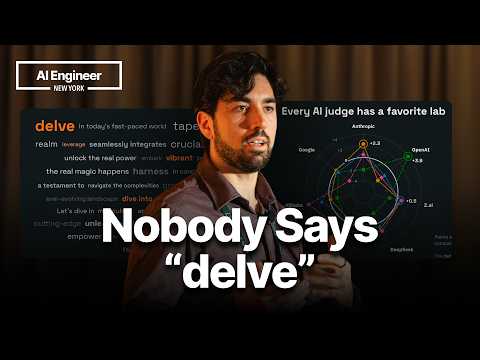
Why AI Writing Still Reads Like Slop — Louis-François Bouchard, Towards AI
핵심 요약
Pengembangan ToneBench membuktikan bahwa kualitas penulisan kreatif AI dapat diukur secara objektif melalui evaluasi multi-model dan rubrik terperinci, di mana model murah yang digabungkan dengan kurasi cerdas memberikan hasil lebih optimal dibandingkan satu generasi model mahal tunggal.
하이라이트
Tulisan AI generatif sering kali terasa kaku dan artifisial karena menggunakan kosa kata yang berlebihan seperti delve dan generaties, bersikap terlalu umum, tidak bermakna, berulang-ulang, berhalusinasi, serta bernada netral yang tidak mencerminkan suara asli penulis.
Tolok ukur ToneBench dirilis untuk mengukur secara kuantitatif kualitas penulisan kreatif dari berbagai model AI menggunakan 10 naskah referensi dan 9 metrik penilaian berbeda.
Biaya awal pembuatan ToneBench mencapai sekitar $500 untuk jam kerja dan 10 naskah, sementara setiap perubahan prompt masukan pada skala penuh menelan biaya lebih dari $4.000.
Pengujian menunjukkan bahwa model OpenAI memiliki bias preferensi yang kuat terhadap keluarga model mereka sendiri dalam penilaian berbasis juri LLM.
Strategi produksi konten skala besar yang paling hemat dan berkualitas tinggi adalah menghasilkan 10 draf menggunakan model murah seperti GLM 5.3 Flash, lalu memilih serta menggabungkan bagian terbaik menggunakan model penalaran tinggi seperti Opus.
타임라인
Definisi dan Masalah Tulisan Buatan AI
Diskusi berpusat pada kekhawatiran fenomena peningkatan teks buatan AI yang tidak bernyawa atau disebut sebagai slop, terutama menjelang tahun 2026. Enam ciri utama diidentifikasi untuk mengklasifikasikan tulisan buruk tersebut, mulai dari penggunaan kosa kata repetitif hingga nada suara yang generik. Upaya mengatasi masalah ini memerlukan pendekatan pengukuran kualitas penulisan yang melampaui sekadar metrik teknis standar EQBench.
- Fenomena slop AI ditandai oleh penggunaan kata klise seperti delve, ketiadaan spesifisitas, minimnya makna substansial, pengulangan narasi, halusinasi data, dan ketidaksesuaian nada suara.
- Peningkatan kecanggihan model seperti Fable dan GPT 6.1 tidak serta-merta menghilangkan tulisan slop, melainkan terus memperluas skalanya di media sosial.
- Tolok ukur ToneBench diciptakan khusus untuk mengevaluasi kualitas penulisan kreatif model AI secara menyeluruh.
Kebutuhan dan Tim Pengembang Tolok Ukur
Kebutuhan mendesak untuk meninjau dan memperbaiki konten edukasi AI secara efisien mendorong tim Towards AI merancang sistem evaluasi mandiri. Pengalaman panjang dalam evaluasi model sejak masa S2 dan S3 menjadi landasan kuat bagi tim untuk membangun tolok ukur ini demi kepentingan komunitas yang lebih luas.
- Divisi edukasi perusahaan Towards AI menerbitkan ribuan artikel dan buku teknik yang membutuhkan model penulisan bebas slop berkualitas tinggi.
- Tim pengembang terdiri dari 15 insinyur AI berpengalaman dalam jalur evaluasi bersama para penulis kreatif dan editor profesional.
- Tanggapan positif dari komunitas di platform X mengonfirmasi tingginya kebutuhan industri akan tolok ukur penulisan kreatif.
Metodologi dan Cara Kerja ToneBench
Proses pengujian dimulai dengan memasukkan prompt mendalam berisi pola bicara dan struktur cerita ke dalam model AI. Setiap model memproses 10 tugas penulisan sebanyak 5 kali untuk mengidentifikasi hasil pencilan dan varians kualitas. Pendekatan ini memastikan penilaian tidak hanya melihat hasil terbaik tunggal, tetapi konsistensi model secara keseluruhan.
- Prompt pengujian berisi ringkasan riset, panduan gaya bahasa, serta contoh naskah sebelumnya untuk menghasilkan skrip video yang menyerupai gaya penulis asli.
- Sebanyak 10 naskah uji coba yang berbeda digunakan untuk menguji kontaminasi data pada berbagai model.
- Setiap model menghasilkan 5 versi draf untuk mengukur variabilitas intramodal pada tugas-tugas kreatif.
Evaluasi, Metrik, dan Tantangan Juri LLM
Penilaian kualitas naskah dilakukan secara otomatis menggunakan juri LLM dengan rubrik terperinci yang mengelompokkan skor ke dalam kategori kualitatif. Untuk mengatasi bias penilai otomatis, tim pengembang juga melibatkan tinjauan manual berbasis perbandingan pasangan AB dengan bantuan rekan kerja guna menjaga objektivitas hasil.
- ToneBench mengukur 9 metrik utama yang diringkas ke dalam aspek nada, kualitas tulisan, kepatuhan instruksi, keakuratan riset, dan tingkat slop.
- Prompt evaluasi berukuran besar sekitar 14.000 kata dikirimkan ke juri LLM yang menilai secara buta tanpa mengetahui model pembuat naskah.
- Model juri LLM seperti OpenAI menunjukkan bias preferensi yang kuat terhadap keluarga model mereka sendiri.
Analisis Biaya dan Strategi Penulisan AI Terbaik
Eksperimen selama empat bulan menunjukkan bahwa model sempurna untuk penulisan kreatif belum tersedia, sehingga fokus utama diarahkan pada model yang paling minim gangguan. Penggunaan model murah untuk draf awal yang digabungkan dengan ulasan model pintar terbukti jauh lebih hemat biaya dan menghasilkan tulisan berkualitas tinggi.
- Biaya awal pengembangan mencapai $500 untuk jam kerja, sementara modifikasi prompt atau rubrik dapat menelan biaya lebih dari $2.000 hingga $4.000.
- Model dengan efisiensi tinggi seperti GLM 5.3 Flash menawarkan hasil sepadan dengan biaya 50 kali lebih murah dibanding model premium.
- Strategi optimal pembuatan konten skala besar melibatkan penghasilan 10 draf lewat model murah, diikuti kurasi bagian terbaik menggunakan model penalaran tinggi.
설명
Louis-François Bouchard of Towards AI breaks down what makes AI writing feel like slop: overused words, vague generalities, saying nothing, repetition, hallucination and a voice that sounds like everyone at once. He then shows how his team built a benchmark to measure whether a model can write a video script in his own voice: 10 scripts, 5 drafts per model, 4 LLM judges, nine scoring metrics and 1,000 human A/B checks. He shares what it cost, why judges favor their own model family, and practical tips for writing with AI: very long prompts full of examples, one review pass from a strong model, many cheap drafts merged together, and always a human edit. Chapters: - 00:00 What is slop? - 02:41 Measuring sloppy writing - 03:49 Why build another benchmark - 05:44 Can a model write like me? - 07:19 10 scripts, 5 drafts, 4 judges - 09:14 What gets measured - 11:10 How the judges score - 12:38 Judges prefer their own models - 13:46 Human A/B checks - 14:15 What it cost - 15:20 What we learned - 16:21 How to write better with AI Louis-François Bouchard, Towards AI: https://towardsai.net Join us in SF for the second annual AIE CODE summit: https://aie.codes our last flagship summit of 2026. Applications live now!