Pourquoi l'écriture de l'IA ressemble toujours à de la bouillie — Louis-François Bouchard, Towards AI
원제 · Why AI Writing Still Reads Like Slop — Louis-François Bouchard, Towards AI
핵심 요약
L'évaluation rigoureuse de l'écriture des IA via ToneBench montre que l'obtention de textes naturels nécessite des prompts extrêmement détaillés, une génération multi-brouillon avec GLM 5.3 Flash et une révision finale par un juge intelligent.
하이라이트
ToneBench évalue la qualité d'écriture créative des grands modèles de langage à travers dix scripts de référence et neuf métriques spécifiques.
La création des scripts de base et la définition des grilles d'évaluation ont coûté initialement environ 500 dollars, tandis que la modification d'une seule ligne de prompt d'entrée dépasse 4 000 dollars.
Le benchmark génère cinq brouillons par modèle pour mesurer la variabilité intramodale et identifier les valeurs aberrantes.
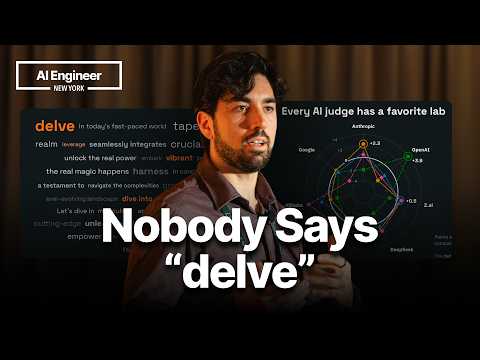
Les juges LLM présentent des biais prononcés, les modèles d'OpenAI favorisant systématiquement toute leur propre famille.
GLM 5.3 Flash offre un excellent rapport qualité-prix en tant que modèle rapide et économique, tandis qu'Opus 5.5 se positionne au sommet pour la qualité d'écriture.
타임라인
Introduction et définition de la slop
Les textes produits par les intelligences artificielles partagent souvent des caractéristiques agaçantes, indépendamment des progrès des modèles. Pour contrer cette propagation de contenus génériques et impersonnels, l'analyse de l'écriture médiocre passe par la création d'un benchmark dédié qui évalue la capacité des modèles à reproduire un ton authentique et spécifique.
- La slop désigne les textes générés par IA caractérisés par des mots surutilisés comme explorer, un contenu trop général et un manque de ton personnel.
- Six éléments principaux constituent cette écriture médiocre, incluant des tournures stéréotypées, des répétitions et des hallucinations.
- ToneBench est lancé pour mesurer précisément la qualité d'écriture créative des modèles de langage.
Justification et besoin d'un nouveau benchmark
La production quotidienne de livres, d'articles et de vidéos éducatives engendre une dépendance aux outils d'IA dont la relecture s'avère extrêmement pénible. Fort d'une solide expérience en évaluation de pipelines d'IA et d'une équipe pluridisciplinaire d'ingénieurs et de rédacteurs, le projet répond à une exigence concrète de productivité éditoriale.
- L'équipe de Towards AI produit de nombreux contenus pédagogiques en ingénierie IA et fait face à la relecture constante de textes de piètre qualité.
- L'expérience de l'équipe dans l'évaluation de modèles depuis la recherche universitaire légitime la conception de cet outil.
- L'engouement suscité sur les réseaux sociaux confirme un besoin partagé par la communauté pour évaluer l'écriture créative.
Conception et fonctionnement de ToneBench
Le protocole d'évaluation repose sur des prompts approfondis intégrant des consignes stylistiques et des exemples concrets de contenu. La génération de cinq brouillons par modèle permet d'identifier les variations de performance et d'isoler les résultats aberrants selon les architectures.
- Le benchmark utilise dix scripts de référence et envoie des instructions détaillées aux modèles testés.
- Cinq brouillons sont générés par modèle pour chaque script afin d'analyser la variabilité intramodale.
- Quatre LLM arbitres évaluent les productions finales selon des grilles de notation rigoureuses.
Métriques et évaluation par les juges LLM
L'évaluation automatisée nécessite des grilles complexes où chaque critère est noté à travers des catégories graduées accompagnées d'exemples. Pour pallier les biais de complaisance des juges automatiques, un travail de comparaison humaine sur 1000 paires de scripts complète le dispositif.
- Neuf métriques réparties en cinq aspects mesurent le ton, la qualité d'écriture, le respect des consignes, la recherche et le niveau de slop.
- Les prompts envoyés aux juges atteignent 14 000 mots pour garantir une analyse contextuelle détaillée.
- Les juges LLM affichent des biais de favoritisme prononcés, notamment envers leur propre famille de modèles comme le démontre la rivalité entre OpenAI et Anthropic.
Coûts de conception et investissement financier
L'expérimentation et l'ajustement des paramètres d'évaluation impliquent des investissements financiers substantiels en raison du volume massif de données générées. Chaque modification structurelle du pipeline d'évaluation requiert une exécution à grande échelle sur de nombreux modèles.
- La phase de lancement initiale a nécessité environ 500 dollars pour formaliser les scripts et les grilles de notation.
- Le coût d'expérimentation est élevé, atteignant plus de 2 000 dollars par modification de la grille de notation.
- Chaque changement de ligne dans le prompt d'entrée d'un modèle engendre un coût supérieur à 4 000 dollars.
Enseignements et recommandations pratiques
L'utilisation efficace des modèles pour l'écriture créative exige des consignes exhaustives et une supervision humaine inévitable. La combinaison d'un modèle rapide pour la génération de masse et d'un modèle analytique pour la sélection garantit un compromis optimal entre coût et qualité éditoriale.
- GLM 5.3 Flash s'avère extrêmement performant et économique, tandis qu'Opus 5.5 domine pour la qualité d'écriture.
- L'utilisation de prompts extrêmement longs et détaillés intégrant des exemples positifs et négatifs améliore considérablement les résultats.
- Une stratégie optimale consiste à générer plusieurs brouillons avec un modèle économique puis à utiliser un juge intelligent pour fusionner les meilleures parties.
설명
Louis-François Bouchard of Towards AI breaks down what makes AI writing feel like slop: overused words, vague generalities, saying nothing, repetition, hallucination and a voice that sounds like everyone at once. He then shows how his team built a benchmark to measure whether a model can write a video script in his own voice: 10 scripts, 5 drafts per model, 4 LLM judges, nine scoring metrics and 1,000 human A/B checks. He shares what it cost, why judges favor their own model family, and practical tips for writing with AI: very long prompts full of examples, one review pass from a strong model, many cheap drafts merged together, and always a human edit. Chapters: - 00:00 What is slop? - 02:41 Measuring sloppy writing - 03:49 Why build another benchmark - 05:44 Can a model write like me? - 07:19 10 scripts, 5 drafts, 4 judges - 09:14 What gets measured - 11:10 How the judges score - 12:38 Judges prefer their own models - 13:46 Human A/B checks - 14:15 What it cost - 15:20 What we learned - 16:21 How to write better with AI Louis-François Bouchard, Towards AI: https://towardsai.net Join us in SF for the second annual AIE CODE summit: https://aie.codes our last flagship summit of 2026. Applications live now!