क्यों एआई राइटिंग अभी भी घटिया लगती है — लुई-फ्रांस्वा बुचार्ड, टुवर्ड्स एआई
원제 · Why AI Writing Still Reads Like Slop — Louis-François Bouchard, Towards AI
핵심 요약
रचनात्मक लेखन में एआई स्लॉप से निपटने के लिए GLM 5.3 Flash जैसे सस्ते मॉडल से पांच ड्राफ्ट जनरेट करके उच्च-विचार वाले जज मॉडल के साथ मर्ज करना सबसे प्रभावी और किफायती तरीका है.
하이라이트
ToneBench एक नया बेंचमार्क है जिसे रचनात्मक लेखन में एआई 'स्लॉप' और टोन की गुणवत्ता को मापने के लिए लॉन्च किया गया है।
बेंचमार्क परीक्षण के दौरान प्रॉम्प्ट में केवल एक लाइन बदलने की लागत $4,000 से अधिक हो जाती है।
GLM 5.3 Flash जैसे सस्ते मॉडल से 10 ड्राफ्ट जनरेट करके ओपस जैसे स्मार्ट जज मॉडल की मदद से बेहतरीन हिस्सों को मर्ज करना सबसे किफायती तरीका है।
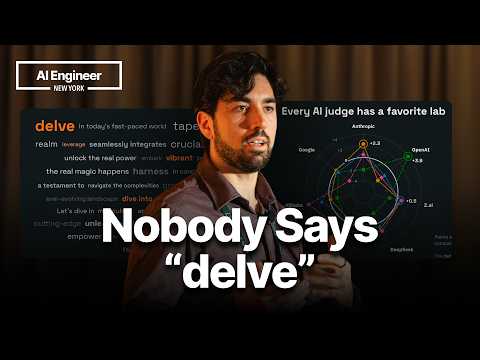
एआई मॉडल मूल्यांकन के दौरान ओपनएआई और एंथ्रोपिक जैसे जज मॉडल अपने स्वयं के परिवार के मॉडलों को मजबूत प्राथमिकता देते हैं।
ToneBench मूल्यांकन प्रक्रिया में मॉडल की टोन, लेखन गुणवत्ता, निर्देश पालन, रिसर्च सटीकता और स्लॉप स्कोर सहित नौ अलग-अलग मेट्रिक्स को मापा जाता है।
타임라인
स्लॉप की परिभाषा और ToneBench की आवश्यकता
एआई मॉडल जैसे फेबल और जीपीटी 6.1 के उन्नत होने के बावजूद एआई लेखन में बेकार और मशीनी टेक्स्ट लगातार बढ़ रहा है। ToneBench का मुख्य उद्देश्य यह मापना है कि कोई एआई मॉडल वास्तविक मानवीय टोन और रचनात्मक लेखन शैली में कितना सक्षम है।
- एआई-जनरेटed टेक्स्ट में अत्यधिक उपयोग किए जाने वाले शब्दों, सामान्य बातों, पुनरावृत्ति, मतिभ्रम और गलत टोन जैसी समस्याओं को 'स्लॉप' कहा जाता है।
- करपाति द्वारा अनुमानित स्लॉपैकैलिप्स से निपटने और एआई लेखन की गुणवत्ता सुधारने के लिए ToneBench नामक नया बेंचमार्क जारी किया गया है।
बेंचमार्क की संरचना और कार्यप्रणाली
छोटी टीम होने के बावजूद कंपनी ने सैकड़ों वीडियो और हजारों लेख प्रकाशित किए हैं, जिसके कारण सर्वोत्तम गैर-स्लॉप मॉडल की आवश्यकता महसूस हुई। मूल्यांकन पाइपलाइन के तहत प्रत्येक मॉडल से पांच ड्राफ्ट जनरेट कराए जाते हैं ताकि इंट्रा-मॉडल वेरिएबिलिटी को मापा जा सके।
- टुवर्ड्स एआई टीम को शैक्षिक एआई इंजीनियरिंग कंटेंट के निर्माण के दौरान लगातार खराब एआई टेक्स्ट की समीक्षा करने में भारी कठिनाई होती है।
- ToneBench में मॉडल का परीक्षण करने के लिए 10 अलग-अलग स्क्रिप्ट्स और विस्तृत रिसर्च ब्रीफ का उपयोग किया जाता है।
मूल्यांकन मेट्रिक्स और जज मॉडल की प्राथमिकताएं
प्रत्येक जज को लगभग 14,000 शब्दों का प्रॉम्प्ट भेजा जाता है जो छह श्रेणियों के आधार पर स्कोर प्रदान करता है। स्वचालित मूल्यांकन की सीमाओं को दूर करने के लिए टीम ने 1,000 मानव एबी जोड़ों की तुलना का भी उपयोग किया है।
- लेखन की गुणवत्ता को मापने के लिए टोन, लेखन मानक, निर्देश पालन, रिसर्च सटीकता और स्लॉप स्कोर सहित नौ अलग-अलग मेट्रिक्स का उपयोग किया जाता है।
- ओपनएआई और अन्य एलएलएम जज मूल्यांकन के दौरान अपने स्वयं के मॉडल परिवार को मजबूत प्राथमिकता देते हैं।
लागत, व्यावहारिक सीख और निष्कर्ष
रचनात्मक लेखन के लिए पूर्णता प्राप्त करना कठिन है, इसलिए GLM 5.3 Flash जैसे सस्ते मॉडल से 10 ड्राफ्ट जनरेट करके ओपस जैसे स्मार्ट जज की मदद से उनके बेहतरीन हिस्सों को मर्ज करना सबसे किफायती है। ToneBench की पूरी कार्यप्रणाली और लीडरबोर्ड अब वेबसाइट पर लाइव उपलब्ध है।
- बेंचमार्क में रुब्रिक या प्रॉम्प्ट में एक भी लाइन बदलने की लागत $2,000 से $4,000 तक आती है।
- बेहतर परिणाम के लिए अत्यधिक लंबे और विस्तृत प्रॉम्प्ट का उपयोग करना चाहिए जिसमें सकारात्मक और नकारात्मक दोनों उदाहरण शामिल हों।
설명
Louis-François Bouchard of Towards AI breaks down what makes AI writing feel like slop: overused words, vague generalities, saying nothing, repetition, hallucination and a voice that sounds like everyone at once. He then shows how his team built a benchmark to measure whether a model can write a video script in his own voice: 10 scripts, 5 drafts per model, 4 LLM judges, nine scoring metrics and 1,000 human A/B checks. He shares what it cost, why judges favor their own model family, and practical tips for writing with AI: very long prompts full of examples, one review pass from a strong model, many cheap drafts merged together, and always a human edit. Chapters: - 00:00 What is slop? - 02:41 Measuring sloppy writing - 03:49 Why build another benchmark - 05:44 Can a model write like me? - 07:19 10 scripts, 5 drafts, 4 judges - 09:14 What gets measured - 11:10 How the judges score - 12:38 Judges prefer their own models - 13:46 Human A/B checks - 14:15 What it cost - 15:20 What we learned - 16:21 How to write better with AI Louis-François Bouchard, Towards AI: https://towardsai.net Join us in SF for the second annual AIE CODE summit: https://aie.codes our last flagship summit of 2026. Applications live now!