Por que a escrita de IA ainda parece lixo — Louis-François Bouchard, Towards AI
Original · Why AI Writing Still Reads Like Slop — Louis-François Bouchard, Towards AI
Key Takeaway
O ToneBench avalia a qualidade da escrita criativa e a presença de texto genérico em inteligência artificial utilizando rubricas automatizadas e múltiplos rascunhos.
Highlights
O ToneBench mede quão desleixada e genérica é a escrita gerada por inteligência artificial.
O benchmark utiliza 10 roteiros diferentes e avalia cinco rascunhos por modelo para medir a variabilidade intramodal.
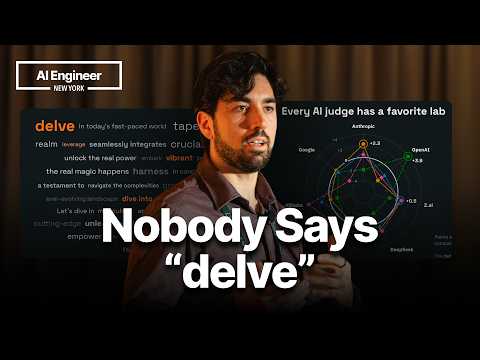
Avaliações com modelos de linguagem exigem cautela devido à preferência marcante que certas famílias de IA demonstram por si mesmas.
A criação do ToneBench exigiu um investimento de centenas de horas e milhares de dólares em testes e assinaturas.
O modelo GLM 5.3 Flash apresenta excelente custo-benefício, custando 50 vezes menos que o Opus 5.5 Extra High com resultados similares.
Timeline
Definição do problema de escrita desleixada
O texto gerado por inteligência artificial apresenta padrões repetitivos, alucinações e um tom genérico que não reflete a voz humana. Mesmo com o avanço tecnológico dos modelos, esse problema persiste e cresce nas redes sociais. Para solucionar essa questão, a iniciativa introduz o ToneBench, um sistema focado em avaliar a qualidade real e a criatividade da escrita automática.
- O texto gerado por inteligência artificial repete termos excessivos como delve e carece de autenticidade.
- Modelos avançados continuam escalando a produção de textos superficiais e genéricos nas redes sociais.
- O ToneBench surge para medir o nível de desleixo na escrita em vez de focar apenas em métricas superficiais de vocabulário.
Justificativa e construção do ToneBench
A criação de conteúdo em larga escala gera a necessidade de ferramentas de avaliação confiáveis para filtrar textos automáticos ruins. O ToneBench utiliza roteiros de referência e diretrizes minuciosas baseadas em exemplos reais de comunicação. Gerar cinco rascunhos por modelo permite identificar quais IAs mantêm estabilidade criativa e quais apresentam grande oscilação de qualidade.
- A Towards AI necessitava de modelos melhores para criar conteúdo educacional sem revisões exaustivas.
- O processo de avaliação utiliza 10 roteiros e prompts detalhados com exemplos de estilo e tom.
- Cada modelo gera múltiplos rascunhos para testar a consistência e a variabilidade das respostas.
Métricas e avaliação por juízes de IA
A quantificação da escrita criativa baseia-se em rubricas detalhadas que pontuam aspectos como tom, engajamento e fidelidade aos dados de pesquisa. Como a automação depende de juízes baseados em modelos, surgem vieses de preferência entre empresas concorrentes. Para mitigar distorções, o processo combina avaliações automatizadas com análises humanas em pares.
- O sistema avalia nove métricas agrupadas em tom, qualidade geral, cumprimento de instruções, precisão da pesquisa e nível de slop.
- Quatro juízes de inteligência artificial analisam os textos gerados sem saber qual modelo os produziu.
- Modelos da OpenAI demonstram forte preferência por conteúdos gerados pela própria família de IAs.
Custos e aprendizados práticos
O desenvolvimento de benchmarks especializados exige investimentos expressivos de tempo e recursos financeiros em chamadas de API. A experiência prática demonstra que prompts extensos e o uso de revisões cruzadas reduzem drasticamente os defeitos nos textos gerados. Estratégias que utilizam modelos rápidos para rascunhos e IAs de raciocínio avançado para filtragem oferecem o melhor retorno econômico.
- Alterações em rubricas ou prompts geram custos operacionais elevados durante a fase de testes.
- Prompts longos e detalhados com exemplos negativos melhoram significativamente o resultado da escrita.
- A combinação de modelos econômicos para rascunhos e modelos avançados para seleção otimiza custos e qualidade.
Description
Louis-François Bouchard of Towards AI breaks down what makes AI writing feel like slop: overused words, vague generalities, saying nothing, repetition, hallucination and a voice that sounds like everyone at once. He then shows how his team built a benchmark to measure whether a model can write a video script in his own voice: 10 scripts, 5 drafts per model, 4 LLM judges, nine scoring metrics and 1,000 human A/B checks. He shares what it cost, why judges favor their own model family, and practical tips for writing with AI: very long prompts full of examples, one review pass from a strong model, many cheap drafts merged together, and always a human edit. Chapters: - 00:00 What is slop? - 02:41 Measuring sloppy writing - 03:49 Why build another benchmark - 05:44 Can a model write like me? - 07:19 10 scripts, 5 drafts, 4 judges - 09:14 What gets measured - 11:10 How the judges score - 12:38 Judges prefer their own models - 13:46 Human A/B checks - 14:15 What it cost - 15:20 What we learned - 16:21 How to write better with AI Louis-François Bouchard, Towards AI: https://towardsai.net Join us in SF for the second annual AIE CODE summit: https://aie.codes our last flagship summit of 2026. Applications live now!