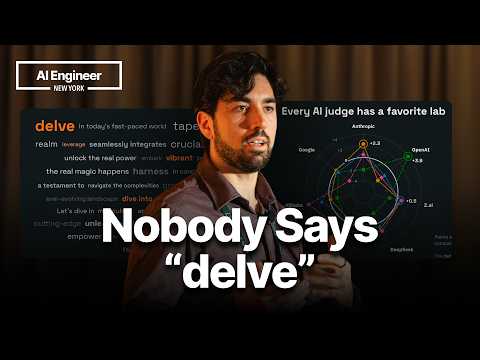
Why AI Writing Still Reads Like Slop — Louis-François Bouchard, Towards AI
Key Takeaway
El benchmark ToneBench cuantifica la escritura descuidada de la IA mediante 10 guiones y 5 borradores por modelo, demostrando que combinar modelos económicos como GLM 5.3 Flash con jueces de alto razonamiento optimiza la producción de contenido.
Highlights
ToneBench evalúa la calidad de escritura creativa y la coincidencia de tono de la IA mediante 10 guiones y 9 métricas detalladas.
Construir el benchmark costó inicialmente unos 500 dólares en tiempo, y modificar una sola línea de instrucción en los modelos supera los 4,000 dólares.
GLM 5.3 Flash ofrece resultados comparables a Opus 5.5 con un costo 50 veces menor en tareas de escritura masiva.
Generar múltiples borradores con un modelo económico y fusionar las mejores partes con un juez de alto razonamiento reduce drásticamente los costos operativos.
Los jueces LLM de OpenAI muestran una fuerte preferencia hacia su propia familia de modelos, lo que exige diversificar los evaluadores para evitar sesgos.
Timeline
Definición del contenido descuidado de la IA y presentación de ToneBench
El fenómeno del contenido masivo de baja calidad, denominado slop, persiste a pesar de las mejoras en los modelos de lenguaje. Las características principales de este texto deficiente incluyen el uso recurrente de vocabulario artificial como delve, la ausencia de información específica y la falta de autenticidad tonal. ToneBench se lanza para cuantificar objetivamente estas deficiencias editoriales en lugar de limitarse a contar palabras clave indeseadas.
- El texto generado por IA con baja calidad abunda en palabras repetitivas, generalidades excesivas, alucinaciones y una falta total de tono personal.
- ToneBench surge para medir de forma rigurosa la calidad de la escritura creativa y la cercanía al tono de voz real.
Justificación del nuevo benchmark y experiencia del equipo
La necesidad de un nuevo benchmark nace de la experiencia directa en la producción de miles de artículos, videos y libros educativos sobre ingeniería de IA. Las interacciones previas en plataformas públicas confirman un interés generalizado de la comunidad por disponer de métricas fiables para la escritura creativa. El equipo combina competencias en evaluación técnica con criterios editoriales humanos para garantizar la utilidad práctica de las métricas.
- Los equipos pequeños de creadores de contenido enfrentan una carga constante al revisar y corregir textos genéricos generados por IA.
- Towards AI aporta experiencia previa en evaluación de modelos y desarrollo de sistemas de control para respaldar la credibilidad del benchmark.
Metodología y arquitectura de evaluación de ToneBench
Cada prueba envía instrucciones detalladas y ejemplos de estilo al modelo evaluado para generar un guion completo. Cuatro jueces LLM analizan las generaciones utilizando rúbricas estructuradas con más de mil palabras de directrices y ejemplos de puntuación. Este proceso automatizado procesa miles de combinaciones entre modelos y tareas para asignar una puntuación final en la tabla de clasificación.
- El benchmark utiliza un conjunto de 10 guiones de referencia y evalúa cinco borradores por cada modelo analizado para medir la variabilidad intramodal.
- La evaluación procesa nueve métricas diferentes agrupadas en tono, calidad literaria, cumplimiento de instrucciones, precisión investigativa y nivel de contenido descuidado.
Sesgos de los jueces LLM y costos de experimentación
El uso de jueces basados en modelos de lenguaje introduce desafíos de sesgo institucional que requieren el uso de familias de modelos cruzadas para validar los resultados. El costo financiero de la experimentación en tareas creativas escala con rapidez debido al volumen masivo de borradores y evaluaciones necesarias. Para mitigar esta carga, el análisis manual de mil pares de comparación AB complementa la validación automática a escala.
- Los modelos evaluadores de OpenAI presentan una marcada preferencia hacia su propia familia tecnológica durante las calificaciones automáticas.
- Modificar una rúbrica de evaluación cuesta más de 2,000 dólares, mientras que alterar una sola línea de instrucciones supera los 4,000 dólares en costos computacionales.
Estrategias prácticas y optimización para la escritura con IA
La búsqueda de la perfección en una sola generación resulta poco realista en la práctica actual de los modelos de lenguaje. Las mejores prácticas recomiendan utilizar borradores múltiples de bajo costo combinados con revisiones de modelos con alta capacidad de razonamiento. La revisión editorial humana sigue siendo un componente indispensable para garantizar la autenticidad final del contenido publicado.
- Escribir con IA requiere prompts extensos que incluyan múltiples ejemplos positivos y negativos específicos del creador.
- Generar diez borradores con un modelo económico como GLM 5.3 Flash y fusionarlos mediante un juez inteligente reduce drásticamente los costos operativos.
Description
Louis-François Bouchard of Towards AI breaks down what makes AI writing feel like slop: overused words, vague generalities, saying nothing, repetition, hallucination and a voice that sounds like everyone at once. He then shows how his team built a benchmark to measure whether a model can write a video script in his own voice: 10 scripts, 5 drafts per model, 4 LLM judges, nine scoring metrics and 1,000 human A/B checks. He shares what it cost, why judges favor their own model family, and practical tips for writing with AI: very long prompts full of examples, one review pass from a strong model, many cheap drafts merged together, and always a human edit. Chapters: - 00:00 What is slop? - 02:41 Measuring sloppy writing - 03:49 Why build another benchmark - 05:44 Can a model write like me? - 07:19 10 scripts, 5 drafts, 4 judges - 09:14 What gets measured - 11:10 How the judges score - 12:38 Judges prefer their own models - 13:46 Human A/B checks - 14:15 What it cost - 15:20 What we learned - 16:21 How to write better with AI Louis-François Bouchard, Towards AI: https://towardsai.net Join us in SF for the second annual AIE CODE summit: https://aie.codes our last flagship summit of 2026. Applications live now!