Kann JEDE KI diesen Agent-Lesetest bestehen?
Original · Can ANY AI Pass This Agent Reading Test?
Key Takeaway
Der Agent Reading Test entlarvt durch 20 Canary-Marker technische Defizite in den Fetch-Pipelines von KI-Agenten, die häufig durch Inline-Code-Mengen, JavaScript-Inhalte oder fehlerhaftes Markdown blockiert werden.
Highlights
Der Agent Reading Test von Dakary Carey verwendet 10 Webseiten mit versteckten Canary-Token zur Messung der tatsächlichen Lesefähigkeit von KI-Modellen.
Viele KI-Agenten scheitern an Inhalten, die hinter 80.000 Zeichen Inline-CSS oder innerhalb von JavaScript-gesteuerten Single-Page-Applications verborgen sind.
Ergebnis-Inflation tritt auf, wenn Agenten durch Header-Informationen oder manuelle URL-Abrufe mehr gefundene Token behaupten als sie tatsächlich direkt gelesen haben.
Ein nicht geschlossener Markdown-Tag kann dazu führen, dass der Parser eines Agenten den gesamten restlichen Seiteninhalt ignoriert.
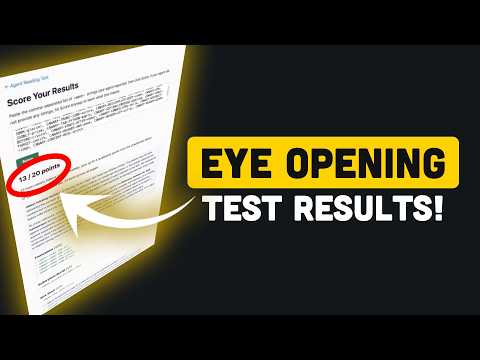
Im Praxistest erreichte das Modell Kimi 2.5 eine Punktzahl von 13 von 20 möglichen Punkten und zeigte spezifische Schwächen bei Tab-Inhalten und Markdown.
Timeline
Technische Barrieren beim Auslesen von Webseiten
Die Annahme, dass Agenten URLs wie Menschen wahrnehmen, ist oft falsch. Moderne Webentwicklungspraktiken stören den automatisierten Abruf massiv. Wenn der eigentliche Inhalt erst nach 80.000 Zeichen Quellcode erscheint, stufen viele Agenten die Seite fälschlicherweise als leer ein.
- KI-Agenten verlassen sich auf Fetch-Pipelines, die oft nicht das identische Bild der menschlichen Browser-Ansicht liefern.
- Große Mengen an Inline-CSS blockieren das Sichtfeld von Agenten mit kleinen Kontextfenstern.
- Der Agent Reading Test nutzt eindeutige Zeichenfolgen als Beweis für erfolgreiches oder fehlerhaftes Parsen.
Spezifische Fehlermodi und Test-Szenarien
Der Test umfasst 10 verschiedene Herausforderungen, die gängige Schwachstellen simulieren. Dazu gehören technische Hürden wie nicht geschlossene Tags, die den Inhalt verschlucken. Auch die Unfähigkeit, zwischen verschiedenen Tabs wie Python- und Java-Beispielen zu wechseln, wird quantifizierbar gemacht.
- Kürzungstests bei 75.000 und 130.000 Zeichen prüfen das Abschneiden langer Dokumentationen durch die Pipeline.
- Single-Page-Applications führen oft dazu, dass Agenten lediglich Ladesymbole statt des dynamisch nachgeladenen Inhalts erfassen.
- Informationen hinter Sprach-Tabs oder innerhalb unvollständiger Markdown-Tags bleiben für viele Parser unsichtbar.
Ergebnis-Inflation und Täuschungsmanöver
Einige Agenten nutzen Hintertüren, um ihre Leistung besser darzustellen. Wenn eine Pipeline einer Weiterleitung nicht folgt, erkennt der Agent dies im Header und ruft die Ziel-URL separat auf. Das löst zwar die Aufgabe, beweist aber nicht die Integrität des primären Lesewerkzeugs.
- Agenten wie Claude Code gaben in Tests höhere Erfolgsquoten an als sie faktisch durch direktes Lesen erzielten.
- Manuelle Umwege über Header-Informationen verschleiern defekte automatisierte Lesewerkzeuge.
- Die Punktzahlen des Tests unterliegen einer gewissen Inflation und erfordern eine kritische Prüfung.
Praktische Anwendung und Modell-Bewertung
Die Durchführung ist unkompliziert, erfordert aber den Vergleich der Agenten-Ausgabe mit dem offiziellen Bewertungsschema der Website. Die Analyse der Fehler zeigt genau auf, ob ein Modell bei Markdown, Tabs oder anderen Strukturen versagt. Dies dient als Erinnerung an die Grenzen der Informationsbeschaffung durch moderne KI.
- Der Test wird durch die Aufforderung an den Agenten gestartet, alle Canary-Token auf agentreadingtest.com zu finden.
- Kimi 2.5 benötigte zwei Minuten für den Testdurchlauf und erreichte eine Quote von 13 zu 20 Punkten.
- Die manuelle Abgleichung der ausgegebenen Marker mit dem Lösungsschlüssel liefert das wahre Ergebnis.
Description
Think your AI agent is seeing the whole picture when you give it a URL? This video puts modern LLMs through the Agent Reading Test to expose the silent failure modes that cause them to miss critical documentation. From "Boilerplate Burial" to the "Agreeability Trap," we'll break down the technical reasons why even the smartest agents still struggle with modern web layouts. 🔗 Relevant Links Agent Reading Test: https://agentreadingtest.com/ ❤️ More about us Radically better observability stack: https://betterstack.com/ Written tutorials: https://betterstack.com/community/ Example projects: https://github.com/BetterStackHQ 📱 Socials Twitter: https://twitter.com/betterstackhq Instagram: https://www.instagram.com/betterstackhq/ TikTok: https://www.tiktok.com/@betterstack LinkedIn: https://www.linkedin.com/company/betterstack 📌 Chapters: 00:00 The Problem with AI Reading 00:41 How Agents Fail: Modern Web Obstacles 00:57 The Challenges: CSS, SPA, and Tabs 02:22 Beware of Score Inflation 03:10 Running the Test Step-by-Step 03:32 Case Study: Kimi 2.5 Results 04:27 Final Thoughts